ChatGPT pille votre blog ? Cette ligne de code fait fuir les crawlers IA et sauve vos revenus pub
Vous publiez des analyses pointues sur vos séries préférées ou vos comptes-rendus détaillés de jeux ? Des crawlers spécialisés sillonnent désormais le web pour nourrir les modèles d’intelligence artificielle. Protéger ses textes uniques devient une priorité pour tout créateur soucieux de garder le contrôle sur son travail.
Pourquoi ces robots ciblent-ils les sites geeks
Les grands noms de l’ia comme OpenAI ou Anthropic déploient des outils d’exploration pour collecter des données fraîches. Ces robots lisent vos critiques de films, vos théories sur les mangas ou vos tests de jeux afin d’enrichir les réponses des chatbots. Sans protection, votre contenu exclusif peut servir à générer des réponses automatiques, privant votre site de visiteurs et de toute reconnaissance.
Des médias influents ont déjà choisi de fermer la porte à ces pratiques pour préserver la valeur de leurs enquêtes originales. En tant que fan ou créateur de contenus pop culture, vous avez les mêmes raisons d’agir : garder le trafic et la crédibilité sur votre plateforme.
Le fichier robots.txt : votre bouclier simple et efficace
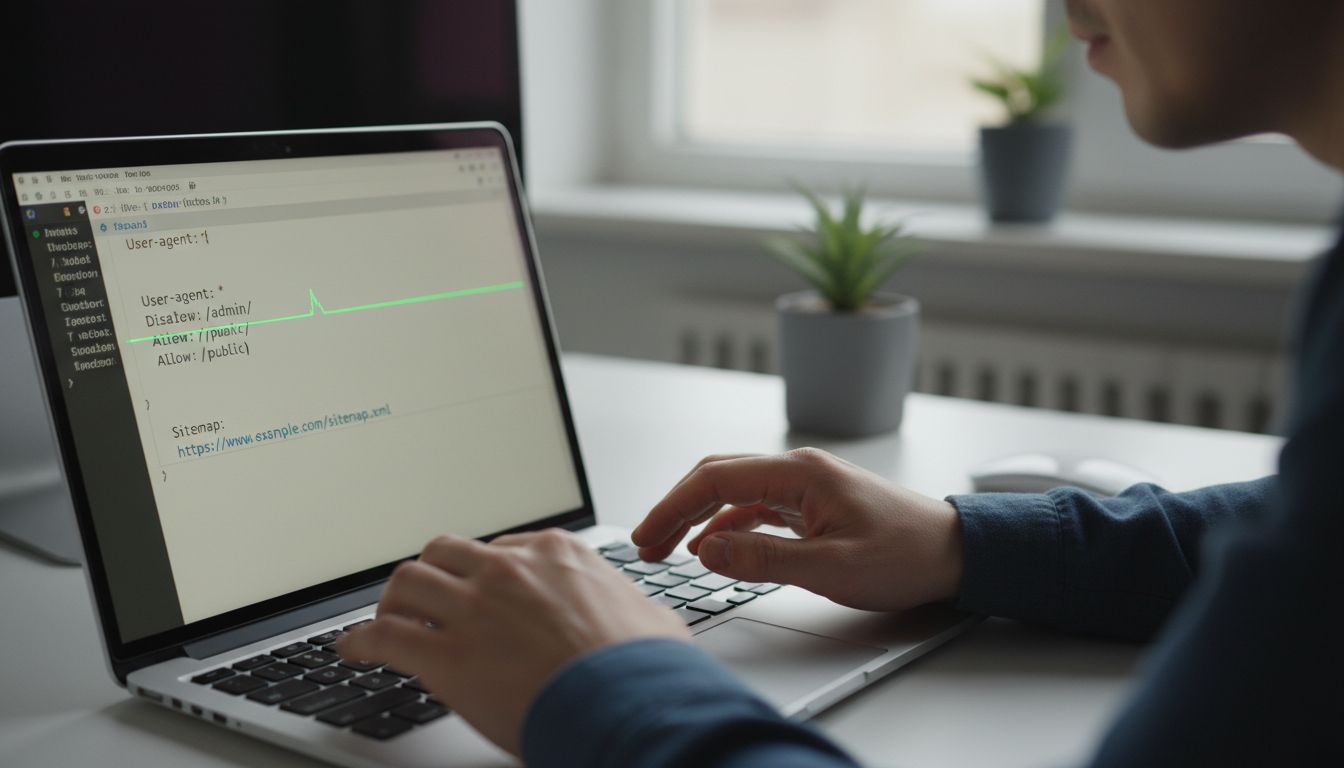
Tout repose sur un fichier texte placé à la racine de votre site. Ce fichier, facile à modifier avec un éditeur basique, indique aux robots ce qu’ils peuvent ou non explorer. Les instructions se concentrent sur le nom de l’agent utilisateur et les règles d’accès.
Les lignes essentielles précisent le User-Agent (nom du robot visé comme GPTBot ou ClaudeBot), puis les directives d’autorisation ou d’interdiction sur l’ensemble du site ou sur certaines pages. Cette méthode, autrefois réservée aux moteurs de recherche classiques, s’applique aujourd’hui parfaitement aux crawlers d’ia.
Les acteurs majeurs respectent généralement ces règles car ignorer les souhaits des propriétaires nuit à leur image. Des services comme Cloudflare renforcent d’ailleurs ces standards en 2026, rendant la protection plus accessible et courante.
Exemples concrets pour bloquer ou autoriser
Pour interdire tout usage en entraînement des modèles tout en laissant les moteurs classiques indexer : indiquez un agent universel suivi des signaux adaptés et d’une interdiction générale. Cela préserve la visibilité dans les résultats classiques sans nourrir l’ia générative.
À l’inverse, si vous souhaitez autoriser un robot précis pour ses capacités de recherche tout en bloquant l’entraînement, ciblez uniquement son nom d’agent et ajustez les permissions. Chaque configuration s’adapte à votre stratégie : protection totale, ouverture sélective ou usage contrôlé.
Des listes actualisées de robots disponibles en 2026 aident à cibler précisément GPTBot, ClaudeBot, Google-Extended et d’autres. Testez toujours le résultat après modification pour vérifier l’efficacité.
Mettre en place ces règles offre une tranquillité immédiate aux créateurs de contenus passionnés. Votre univers geek reste le vôtre, sans être dilué dans des réponses automatisées.